题目内容
讯飞星火Spark-Audio 1.0预览版上线,系全国产语音基座大模型
题目答案
科大讯飞正式上线Spark-Audio-1.0-Preview,这是一款基于全国产算力训l练的语音基座大模型。
此前音频大模型普遍采用级联方案,先将语音转成文字再交由模型理解,存在两处明显短板:一是信息丢失,会遗漏语气、情绪、环境音等
关键信息;二是链路割裂,多模块串联运行易累积错误,还会出现延迟卡顿。
这款语音基座大模型可直接理解语音,一次性识别人声、环境音、音乐等内容,同时读懂语义、情绪与场景,解决了传统方案的痛点。
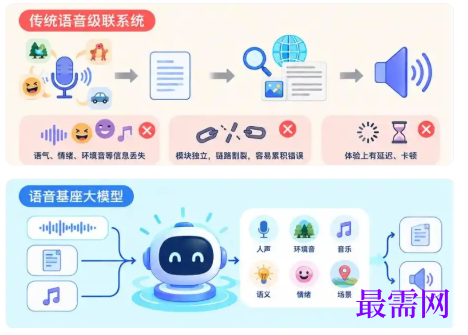
Spark-Audio-1.0-Preview是地道的国产语音基座大模型,采用0.65B音频编码器搭配30B-A3B大语言模型,基于1300万小时音频与海量文本数据,通过纯国产算力集群训练完成。它支持音文双模态输入,可完成语音转写、多语言翻译等多项任务,覆盖99种语言与202种方言,推动机器从“听清”走向“听懂”。该模型多项评测表现亮眼,复杂场景优势明显,通用能力无明显降智,后续将巩固优势、补齐短板。
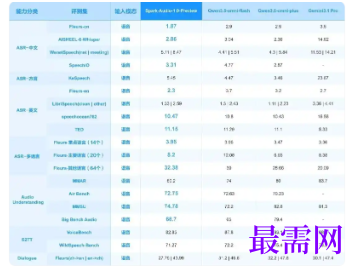
音频公开测试集
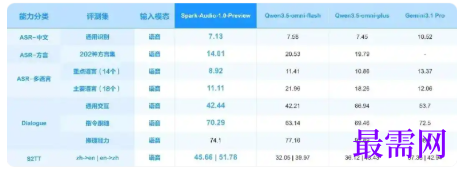
自建音频测试集
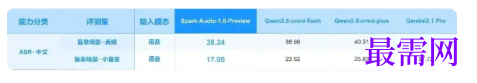
复杂场景自建音频测试集
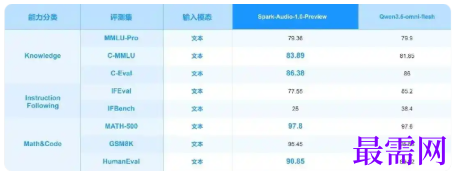
文本公开测试集
注:ASR语音识别相关任务以WER、CER为评价指标,数值越低表现越好;S2TT语音翻译任务采用BLEU分作为评价指标;其余任务均使用准确率指标,数值越高表现越好。


点击加载更多评论>>